
El problema no era dibujar más gráficas
Cuando empezamos a revisar la pantalla de progreso de Blupoli Puzzles, la tentación más obvia era trabajar desde fuera hacia dentro: más tarjetas, más gráficas, más comparaciones y más filtros. El código, sin embargo, señalaba un problema anterior. Si la plataforma no podía responder con precisión a una pregunta tan básica como «¿cuándo empieza realmente una partida?», cualquier visualización construida encima podía ser atractiva y seguir contando una historia incorrecta.
Hasta esta iteración, parte de la telemetría local heredada utilizaba una idea amplia de plays. Dependiendo de la versión del almacenamiento y del motor, abrir, cargar o generar un tablero podía dejar una señal parecida a la de haber jugado. Ese comportamiento era comprensible cuando el objetivo era saber si una persona había pasado por un juego, pero dejaba de ser suficiente en cuanto quisimos calcular tasas de finalización, partidas abandonadas, medias por dificultad o evolución de marcas personales.
La PR #170 nació de esa diferencia. Su objetivo no era añadir el sistema de logros —que se estaba diseñando por separado— ni resolver todavía la reanudación completa de partidas. El objetivo era más pequeño y más fundamental: definir un ciclo de vida común, migrar los datos antiguos sin inventar historia y hacer que toda la analítica nueva partiera de evidencia que la plataforma realmente puede demostrar.
Generar un tablero no significa jugarlo
La decisión que más cambió el sistema puede resumirse en una frase: una partida empieza con la primera interacción significativa del jugador, no cuando existe un tablero en pantalla. Esa frontera parece semántica, pero afecta a casi todo. Una visita curiosa al catálogo deja de inflar el número de intentos. Recargar una partida guardada no crea una sesión nueva por sí sola. Pedir un tablero nuevo sólo abandona el anterior si el anterior había empezado de verdad.
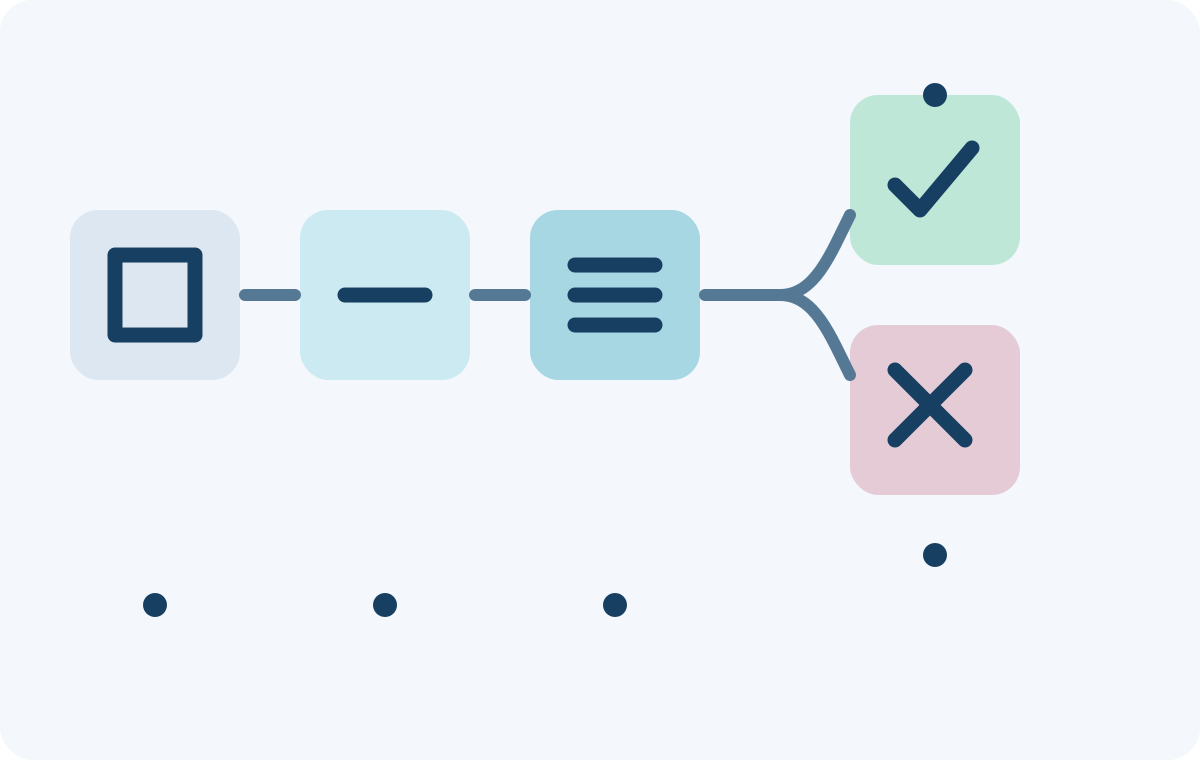
El ciclo compartido quedó expresado con estados explícitos: gameGenerated, gameStarted, gameUpdated, gameCompleted y gameAbandoned. El host común conoce esas transiciones, mientras cada motor conserva su lógica específica. La primera acción útil llama al inicio una sola vez; las acciones posteriores actualizan métricas; resolver o terminar cierra el resultado; sustituir un intento iniciado lo marca como abandonado.
Esto evita una clase de error especialmente molesta en productos con muchos juegos. Si cada motor decide de manera informal cuándo cuenta una partida, dos gráficos que parecen comparar lo mismo pueden estar comparando eventos diferentes. Al mover la semántica al contrato compartido, la plataforma puede preguntar por partidas iniciadas, terminadas y no finalizadas con una definición estable.
La tasa de finalización necesitaba un denominador fiable
Una tasa de finalización sólo es útil si el denominador significa algo. Con la nueva semántica, la fórmula se vuelve deliberadamente sencilla: partidas completadas divididas entre partidas realmente iniciadas. La misma regla se aplica al resumen global y, cuando existen datos suficientes, a juego, categoría, modo, tamaño, dificultad y variante.
El cambio importante no está en la división, sino en todo lo que se hizo para que ambos números sean comparables. Los tableros visitados no cuentan como intentos. Un intento empezado y sustituido sí cuenta como abandonado. Un resultado competitivo puede terminar en victoria, derrota o empate sin fingir que todos esos casos equivalen a «puzzle resuelto». Los motores que no conocen una métrica concreta no rellenan huecos con ceros que parezcan mediciones reales.
Ese último punto es crucial. En analítica es muy fácil convertir «no sé» en «cero» por comodidad. Pero cero movimientos, cero errores o cero segundos tienen significado propio. Cuando el sistema histórico no puede demostrar una cifra, el nuevo contrato conserva null o deja la dimensión fuera del cálculo. La pantalla puede enseñar menos datos, pero los que enseña tienen una procedencia clara.
Migrar sin reescribir el pasado
El almacenamiento agregado pasó a blupoli.progress.v4 y la actividad diaria a blupoli.activity.v2. Eso planteó una pregunta incómoda: ¿qué hacemos con instalaciones que ya tienen contadores de versiones anteriores si parte de esos plays pudo incluir simples visitas?
La salida fácil habría sido reinterpretar todos los valores antiguos como partidas iniciadas. Habría conservado números grandes y gráficos llenos, pero también habría fabricado precisión. La alternativa elegida fue conservadora. Los valores históricos potencialmente contaminados se guardan como legacyPlays para exportación y depuración, pero no inflan las tasas actuales. Sólo se promueven a «inicios demostrables» los eventos que pueden inferirse con seguridad a partir de resultados completados.
La misma idea aparece en la migración de actividad diaria. Los recuentos antiguos no se convierten automáticamente en sesiones. Cuando sólo podemos demostrar solved + competitive, esa suma es la base histórica. No se reconstruyen fechas, duraciones, tamaños o dificultades que nunca fueron almacenados. El resultado es menos espectacular que una migración que «rellena» todo, pero mucho más honesto.
Dos niveles de almacenamiento para dos tipos de pregunta
El sistema mantiene una separación intencionada entre agregados rápidos y resultados detallados. Los agregados sirven para responder con poco coste a preguntas frecuentes: cuántas partidas se han iniciado, cuántas se han resuelto, cuál es el mejor tiempo conocido o qué juegos se han probado. El historial detallado vive en IndexedDB, dentro de la base blupoli-progress y su almacén sessions.
Cada resultado detallado pasa por el contrato común GameResult. Ahí aparecen identificadores estables, modo, inicio y final, estado, resultado, duración, movimientos, pistas, errores, tamaño, dificultad, si era reto diario y otras métricas opcionales. Las métricas específicas de un juego pueden viajar dentro de metadata sin obligar a convertir el esquema común en una lista interminable de campos especiales.
Esta separación también protege el rendimiento de la interfaz. El dashboard no necesita recorrer siempre todo el historial para mostrar un resumen. Cuando sí necesita medias, medianas, tendencias o marcas personales, puede consultar sesiones detalladas. Es un compromiso razonable entre velocidad y riqueza sin convertir localStorage en una base de datos improvisada.
El detalle que protege el último resultado
IndexedDB es asíncrono. Eso normalmente es una ventaja, pero introduce una situación delicada justo al terminar una partida: el usuario puede navegar, recargar o cerrar la pestaña antes de que la transacción haya terminado. Para evitar que el último resultado dependa de esa ventana, el repositorio escribe primero una cola duradera en localStorage, blupoli.sessions.queue.v1, y después intenta persistir en IndexedDB.
En la siguiente lectura o visita, cualquier elemento pendiente se vacía hacia la base detallada. La cola no sustituye a IndexedDB ni pretende ser un segundo historial completo. Actúa como puente contra una carrera de navegación. Es una solución pequeña, pero importante porque el momento más valioso para las estadísticas es precisamente el que ocurre justo antes de que el jugador pueda abandonar la página.
Una vez que el resultado normalizado entra en esa cola, el repositorio emite el evento blupoli:game-result. Esa decisión terminó siendo útil más allá de las estadísticas: otros sistemas pueden reaccionar al resultado sin integrarse uno por uno con cada motor. El sistema de logros construido después se apoya justamente en esta frontera.
Analítica pura encima de un repositorio intercambiable
static/js/progress-analytics.js contiene funciones que reciben sesiones, agregados y catálogo y devuelven series o resúmenes. No necesitan saber si esos datos vienen de IndexedDB, de un fichero de prueba o, en el futuro, de un repositorio remoto. Esa separación fue deliberada porque el producto sigue siendo local-first, pero ya existe una dirección clara para sincronización con cuentas.
La consecuencia práctica es que gráficos y cálculos no tienen que reescribirse cuando cambie la persistencia. La serie diaria, las comparaciones entre periodos, las tasas de finalización, el rendimiento por categoría y las tendencias por juego se calculan a partir de estructuras normalizadas. Una capa de sincronización futura puede cambiar de dónde llegan los datos sin cambiar qué significan.
También facilita los tests. Una función que calcula una mediana o una racha general puede recibir un conjunto pequeño de sesiones fabricadas para la prueba sin levantar el navegador entero. En una plataforma con muchos motores, reducir el número de capas necesarias para probar una regla mejora mucho la capacidad de detectar regresiones.
Qué métricas merecían aparecer
Una vez corregida la semántica de sesión, el dashboard pudo crecer con menos miedo. La PR añadió partidas iniciadas, completadas y sin finalizar; anillos de finalización global; exploración de juegos y categorías; rendimiento por juego, modo, tamaño, dificultad y variante; y estadísticas de tiempo cuando existe historial suficiente.
El sistema calcula media, mediana y mejor tiempo porque cada una cuenta una parte distinta de la historia. La media reacciona a partidas muy largas; la mediana resiste mejor los extremos; la mejor marca sirve para comparar al jugador consigo mismo. Ninguna se muestra como si existiera cuando el historial no la puede respaldar.
Los récords globales siguen la misma filosofía. Máximo diario, mejor ventana de siete días o variedad de juegos por día pueden derivarse de actividad registrada. En cambio, una «mejor racha histórica por dificultad» no se fabrica si versiones antiguas no guardaban esa dimensión. El diseño del dashboard terminó dependiendo tanto de saber qué no afirmar como de saber qué calcular.
Progreso no es lo mismo que reto diario
Durante el trabajo también se hizo explícita otra frontera que era fácil mezclar. La actividad general del jugador y las rachas de retos diarios no son el mismo sistema. blupoli.activity.v2 registra actividad real del catálogo. Las rachas diarias sólo avanzan cuando un resultado lleva isDaily.
Esa separación evita efectos extraños. Completar cinco puzzles normales un martes puede mejorar las estadísticas generales, pero no debe mantener viva una racha cuyo significado es haber completado el reto diario. A la inversa, el reto diario sigue entrando en el historial común como una sesión normal con contexto adicional, de modo que no necesitamos dos formatos incompatibles de resultado.
Es un patrón que se repite en la arquitectura: compartir el evento base y especializar la interpretación. El motor sólo informa de lo que ocurrió. Progreso, rachas, logros o una futura sincronización deciden qué hacer con ese resultado.
La pantalla empezó a poder responder preguntas reales
Antes de esta iteración, una pantalla de estadísticas podía responder sobre todo «cuántas veces se ha tocado este juego» y «cuántas veces se ha resuelto». Después, puede distinguir exploración de compromiso. ¿Qué categorías se han probado? ¿En cuáles se terminan más intentos? ¿Qué juego concentra más sesiones? ¿Está mejorando el tiempo? ¿Cuántas partidas se empiezan y se dejan?
Estas preguntas son más útiles porque no premian simplemente abrir muchas páginas. También son más sensibles: una tasa baja de finalización puede significar dificultad, falta de tiempo o simplemente que el jugador experimenta. El dashboard no intenta convertir cada número en un juicio. Su trabajo es mostrar evidencia de forma coherente.
Eso condicionó el tono visual. Los anillos y resúmenes deben ayudar a orientarse, no convertir el progreso en una puntuación moral. La información sirve para que el jugador vea su propia trayectoria y para que futuras funciones —como logros o recomendaciones— partan de un historial técnicamente consistente.
Por qué no reconstruimos sesiones antiguas
Uno de los límites más deliberados fue no crear resultados detallados ficticios a partir de agregados históricos. Podríamos haber distribuido un contador antiguo entre días, estimado duraciones o supuesto dificultades por defecto. Habría producido un dashboard más poblado desde el primer momento, pero habría mezclado datos observados con datos inventados sin una frontera visible.
En su lugar, el historial detallado empieza cuando la plataforma puede medirlo. Los agregados antiguos sobreviven para no perder contexto, pero no se disfrazan de precisión nueva. Esta decisión también simplifica una futura sincronización: un GameResult remoto puede tratarse como un evento real con identificador estable, no como una estimación nacida de un contador.
Es una de las lecciones menos vistosas de la iteración. Migrar no significa necesariamente convertir todo al formato nuevo. A veces la migración correcta conserva una parte como legado precisamente para no mentir sobre lo que sabemos.
Local-first ahora, sincronizable después
La documentación deja claro que el progreso personal sigue siendo local. Firebase Analytics no se usa como base de datos del dashboard y Firestore no recibe todavía estas sesiones. El navegador es la fuente inmediata para la experiencia del jugador.
Aun así, el modelo futuro ya puede describirse sin cambiar el contrato: sesiones por usuario, agregados por juego, actividad diaria y logros. Los resultados tienen identificadores estables y el dashboard consume una API de repositorio, no IndexedDB directamente. Cuando llegue autenticación, la sincronización podrá hacer upsert por identificador y mantener IndexedDB como caché offline.
Preparar esa frontera ahora evita un tipo de reescritura costosa más adelante. No necesitamos implementar cuentas para diseñar datos que puedan sobrevivir a una cuenta. Tampoco necesitamos retrasar el dashboard hasta que exista backend. La arquitectura actual permite avanzar en ambas direcciones sin confundirlas.
Los tests se convirtieron en parte de la definición
La PR no se limitó a modificar almacenamiento y UI. Los tests comprobaron el contrato de resultados, la cobertura de juegos disponibles, el dashboard y el runtime compartido. La intención era que reglas como «un tablero generado no cuenta», «la primera interacción inicia una sola sesión» o «un intento empezado puede acabar abandonado» dejaran de ser convenciones fáciles de romper.
Esto importa porque los motores no son idénticos. Numberlink arrastra caminos, Ataxx mueve fichas, Dots and Boxes alterna líneas y Sudoku introduce números. El gesto inicial cambia, pero la consecuencia estadística debe ser la misma: al primer acto que modifica o compromete la partida, la sesión pasa de preparada a iniciada.
La cobertura transversal no elimina la necesidad de pruebas específicas por juego. Lo que hace es proteger la capa común para que una corrección local no vuelva a convertir una visita en una partida o una derrota competitiva en un puzzle resuelto.
Lo que dejamos fuera a propósito
Dos asuntos quedaron explícitamente fuera del alcance. El primero era el nuevo sistema definitivo de logros. Necesitaba esta base de resultados fiable, pero mezclar ambas implementaciones habría hecho más difícil revisar qué parte corregía datos y qué parte añadía producto. El segundo era la reanudación universal mediante snapshots y una interfaz completa de «Continuar jugando».
El lifecycle correcto ayuda a ambos trabajos. Un snapshot reanudable necesita saber si la partida había empezado y qué estado conserva. Un logro necesita saber si el resultado que evalúa es real y qué métricas estaban medidas. Pero disponer de la base no significa que esas capas estén terminadas.
Separar los cambios por contrato permitió que la PR #170 tuviera un criterio de éxito concreto: las estadísticas dejan de contar presencia como juego y el historial nuevo queda preparado para análisis detallado. Lo demás puede crecer encima.
Qué cambió para el jugador aunque no vea el esquema v4
La mayoría de jugadores nunca sabrá que existe blupoli.progress.v4, y eso está bien. La mejora visible es más sencilla: las cifras empiezan a corresponderse mejor con lo que la persona recuerda haber hecho. Abrir un puzzle y volver atrás no empeora su porcentaje. Empezar uno y abandonarlo sí forma parte de la historia. Terminar una partida competitiva se registra con su resultado real.
También aparece una progresión más rica sin pedir cuenta. El navegador puede mostrar exploración, rendimiento, tiempos, tendencias y marcas personales manteniendo los datos personales en local. Ese enfoque encaja con el estado actual del producto: ofrecer valor inmediato y dejar la sincronización como una capacidad posterior, no como requisito para jugar.
Desde el punto de vista de mantenimiento, el cambio todavía es más importante. Las nuevas superficies no necesitan preguntar a cada juego por separado qué significa jugar. Pueden consumir el mismo contrato y concentrarse en presentar la información.
La lección: antes de medir más, define mejor el evento
La parte más útil de esta iteración no es una gráfica concreta. Es recordar que la calidad de una analítica empieza antes de la visualización. Si el evento base es ambiguo, añadir más dimensiones sólo multiplica la ambigüedad. Si el evento está bien definido, incluso un resumen sencillo puede ser fiable.
En Blupoli Puzzles eso significó aceptar que algunos datos históricos no podían convertirse limpiamente, diseñar una migración conservadora y mover la primera interacción al centro del lifecycle. A partir de ahí, media, mediana, abandono, exploración o récords dejaron de ser adornos y pasaron a ser derivaciones de una historia medible.
El siguiente paso ya no consiste en volver a discutir qué es una partida. Esa decisión queda escrita en el contrato, en el almacenamiento y en los tests. Esa estabilidad es precisamente lo que permite que progreso, logros y futuras cuentas evolucionen sin tener que reinterpretar el pasado cada vez.
La diferencia entre “partida no terminada” y “partida abandonada”
Otra precisión útil apareció al modelar los estados. Un tablero generado que nadie toca no es una partida no terminada: todavía no es una partida. En cambio, una sesión que sí arrancó y después se sustituye por otro tablero puede cerrarse como abandonada. Esa distinción evita que el dashboard castigue la exploración superficial y, al mismo tiempo, permite reconocer intentos reales que no llegaron al final.
También obliga a pensar mejor en los límites de navegación. Cerrar una pestaña no siempre permite ejecutar lógica de despedida fiable, de modo que el sistema no pretende detectar de forma mágica cada abandono posible. Lo que registra son cierres que puede demostrar dentro del lifecycle controlado. Esta prudencia es coherente con la migración: preferimos una métrica incompleta pero defendible a una cifra completa construida sobre suposiciones.
El resultado es una semántica más útil para futuros análisis. “Sin finalizar” puede derivarse de partidas iniciadas menos partidas completadas en los agregados disponibles, mientras los resultados detallados pueden marcar abandonos explícitos cuando el host los conoce. No se fuerza a ambas capas a fingir el mismo nivel de observación.
Modos competitivos y puzzles comparten sesión, no significado
Ataxx y Dots and Boxes fueron recordatorios prácticos de que una plataforma de puzzles no puede asumir que todo acaba en solved. El contrato común admite modo competitivo y resultados como victoria, derrota o empate. Eso permite que la analítica cuente una partida terminada sin convertir una derrota en éxito ni esconderla como si no hubiera ocurrido.
Al mismo tiempo, el resumen global puede decidir qué pregunta está respondiendo. Para “partidas completadas”, una derrota o empate son cierres válidos. Para “juegos dominados” o determinados logros, el criterio puede ser distinto. El dato base conserva la realidad; cada capa de producto aplica después su propia semántica.
Esta decisión reduce acoplamiento. El motor competitivo no necesita saber cómo se dibuja una gráfica de progreso y la gráfica no necesita conocer las reglas de captura de Ataxx. Ambos se encuentran en un resultado normalizado que expresa modo, estado y outcome.
El catálogo también forma parte del cálculo
Las estadísticas por categoría no se pueden calcular únicamente desde sesiones. Necesitan saber qué juego pertenece a qué categorías, si está disponible y cuál es su modo. Por eso las funciones de analítica reciben también el catálogo canónico. El catálogo aporta contexto; el historial aporta evidencia de uso.
Esto es especialmente importante ahora que un juego puede pertenecer a más de una categoría. Una misma sesión puede contribuir a la lectura de varias familias cognitivas sin duplicar el resultado original. La capa analítica proyecta el mismo evento sobre las categorías correspondientes y mantiene el evento almacenado una sola vez.
La arquitectura evita así guardar “estadísticas de categoría” como verdad primaria. Son derivadas que pueden recalcularse si cambia la taxonomía. Eso deja margen para reorganizar el catálogo sin migrar cada sesión histórica cada vez que refinamos una categoría.
Exportar también obliga a ser explícito
El snapshot de exportación incluye agregados, actividad general, actividad diaria, estado de logros y resultados detallados. Poder sacar los datos fuera del navegador parece una función secundaria, pero funciona como prueba de arquitectura: si no sabemos describir el estado del jugador en un sobre coherente, probablemente las fronteras internas tampoco están claras.
La exportación conserva legado cuando hace falta, pero lo etiqueta como legado. No convierte contadores antiguos en sesiones. Esa transparencia será importante si más adelante ofrecemos importación o sincronización entre dispositivos, porque permitirá resolver conflictos conociendo qué valores son eventos y cuáles son resúmenes heredados.
El mismo criterio se aplica al borrado. Limpiar progreso tiene que eliminar agregados, actividad, sesiones detalladas y estado de logros relacionado. Una función de privacidad o reinicio sólo es fiable si conoce todas las capas que constituyen el estado personal.
Qué nos llevamos a la siguiente iteración
La pantalla de progreso seguirá cambiando. Ya estamos pensando en una navegación donde las categorías funcionen como eje y donde varias series puedan compararse o superponerse. Ese trabajo de UI tendrá sentido precisamente porque la base ya distingue sesiones reales, categorías, juegos y dimensiones de rendimiento.
Lo importante es mantener el orden de dependencias. Primero definimos qué ocurrió. Después lo almacenamos sin inventar datos. Luego derivamos métricas puras. Finalmente decidimos cómo representarlas. Saltarse una de esas capas suele reaparecer más tarde como excepción visual, migración difícil o número imposible de explicar.
PR #170 no cerró todo el futuro del progreso. Cerró algo más valioso: una definición común suficientemente estricta para que el futuro no tenga que volver a empezar por el significado de “jugar”.
Lecturas relacionadas
Este trabajo continúa la transición descrita en De añadir juegos a construir una plataforma verificable y conecta directamente con el panel de progreso de Blupoli Puzzles. Para el contexto de producto y responsive, también está De un catálogo enorme a una plataforma usable.