La cantidad dejó de ser la métrica útil
Durante una fase temprana de una colección de puzzles es fácil medir el avance contando motores, carpetas o tarjetas en el catálogo. Esa medida deja de servir en cuanto los juegos empiezan a diferir de verdad. Un Sudoku sencillo y un Dots and Boxes contra CPU pueden ocupar una tarjeta cada uno, pero los contratos que necesitan son muy distintos. Uno debe demostrar una solución única; el otro debe conservar turnos extra y registrar victoria, derrota o empate.
Los últimos cambios han obligado a mirar Blupoli Puzzles de otra manera. Logic Matrix y Zebra Grid añadieron matrices de candidatos y generación relacional. Dots and Boxes añadió búsqueda contra CPU. Numberlink creció hasta 8×8, 10×10, 12×12 y 15×15. Las rachas pasaron de un contador asociado a retos diarios a una sección de analítica completa. Todo esto hizo visible una pregunta más importante que “¿cuántos juegos hay?”: “¿qué significa que un juego esté realmente terminado dentro de la plataforma?”.
Logic Matrix y Zebra Grid: dos juegos parecidos que no podían ser el mismo
El punto de partida parecía tentador: ambos juegos podían usar una matriz de categorías, posiciones y candidatos. Reutilizar el mismo tablero era razonable. Reutilizar también el lenguaje de pistas, no. Zebra Grid nació para manejar relaciones amplias en matrices grandes. Logic Matrix tenía que acercarse a un formato mucho más compacto, con pocas pistas horizontales y verticales y una lectura más cercana a los acertijos gráficos de eliminación.
La diferencia obligó a separar núcleo compartido y comportamiento específico. Zebra Grid creció a 6×6, 8×8, 10×10 y 12×12, y en escritorio las pistas pasaron a una columna lateral para no encoger el tablero. Logic Matrix quedó en 4×4 a 7×7 y organizó pistas horizontales y verticales por separado. El código podía compartir ideas, pero la interfaz debía respetar el ritmo de cada puzzle.
También apareció un problema que no se arregla con CSS: la dificultad. Contar pistas no bastaba. Dos tableros con el mismo número de relaciones podían ser muy distintos si uno estaba lleno de pistas directas y el otro exigía encadenar “entre”, “no adyacente” y relaciones negativas. Los tests acabaron midiendo estructura, no sólo cantidad.
Cuando “se puede generar” no significa “es un buen puzzle”
Logic Matrix y Zebra Grid reforzaron una regla que ya se había vuelto central en otros motores: generar una solución conocida es sólo el principio. Después hay que comprobar que todas las pistas son verdaderas, que el puzzle se resuelve lógicamente sin adivinar y que no existe una segunda solución.
Ese contrato está codificado en los tests. Para una semilla dada, el generador debe ser determinista. El solver lógico debe terminar. El contador de soluciones debe devolver exactamente una. En Logic Matrix, además, las familias de pistas visibles están restringidas a las que corresponden al diseño del juego; una relación interna útil para generar no tiene por qué convertirse en una pista que el jugador vea.
Esta distinción entre “motor que produce tableros” y “motor que produce partidas publicables” ha terminado siendo una de las ideas más importantes del proyecto. Evita que la aleatoriedad o una demostración superficial sustituyan a una garantía.
Numberlink mostró otra clase de límite
Numberlink ya funcionaba, pero los tamaños pequeños no representaban la experiencia que queríamos. El salto a 8×8, 10×10, 12×12 y 15×15 cambió el problema. El generador tenía que seguir encontrando tableros válidos, las dificultades tenían que conservar diferencias reales y el arranque no podía intentar cargar un tamaño que ya no perteneciera al conjunto soportado.
Ese último detalle produjo una regresión muy reveladora: después de ampliar tamaños, el valor inicial todavía apuntaba a una configuración anterior. El juego podía tener un generador correcto y tests complejos, pero fallar antes de empezar por una discrepancia sencilla entre configuración y catálogo. La solución incluyó una corrección y un test específico para que el tamaño inicial vuelva a formar parte del contrato.
Es el tipo de fallo que recuerda por qué una plataforma necesita verificaciones transversales. No basta con probar la parte “difícil” del algoritmo; también hay que comprobar que las piezas pequeñas que lo conectan al producto siguen alineadas.
Dots and Boxes rompió el supuesto de que todos los juegos “se resuelven”
La mayoría de los motores anteriores terminaban en un estado solved. Dots and Boxes no. Puede terminar con victoria, derrota o empate. Además, cerrar una caja conserva el turno, de modo que una IA que alternase jugador después de cada línea modelaría mal el juego aunque el tablero se dibujara perfectamente.
El motor acabó incorporando cuatro niveles de CPU. Los superiores utilizan búsqueda con poda alpha-beta, evaluación de cadenas y riesgo y presupuestos de profundidad mayores. Los tests verifican invariantes especialmente fáciles de romper: una captura mantiene al mismo jugador, una línea puede cerrar dos cajas y la búsqueda avanzada conserva alternativas tácticas de entrega.
Pero el cambio más importante para la plataforma fue conceptual. El sistema común de resultados tuvo que distinguir entre completar un puzzle y terminar una partida competitiva. Una victoria puede contar como actividad lograda; una derrota o un empate deben registrarse sin fingir que equivalen a un puzzle resuelto.
El resultado común empezó a unir juegos que antes terminaban solos
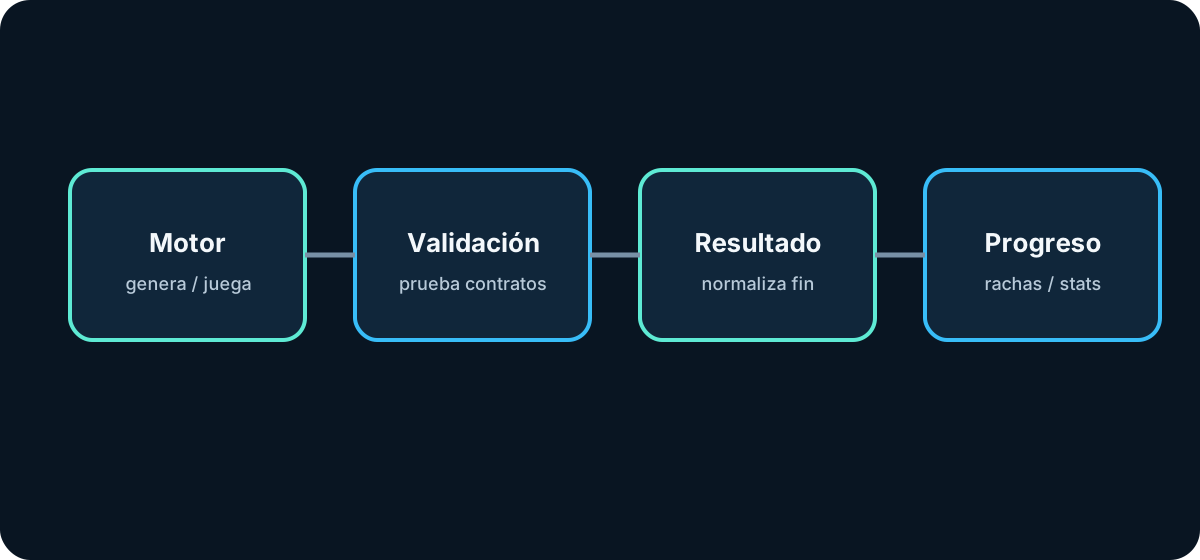
Con muchos motores independientes, cada uno puede mostrar su propio mensaje de “completado” y parecer suficiente. En cuanto aparecen progreso, estadísticas, rachas y retos diarios, esa libertad se convierte en deuda. La plataforma necesita saber de forma uniforme cuándo empieza una sesión, cuándo termina, qué resultado tuvo y qué datos acompañan ese resultado.
El test de cobertura de resultados recorre todos los juegos con status: available. Para motores nativos de puzzle exige un camino hacia markSolved() o el callback compartido de finalización. Para juegos competitivos exige markCompetitiveResult(). El host común, además, crea y abandona sesiones de forma explícita.
Ese tipo de test no mejora un puzzle concreto. Mejora la plataforma entera porque transforma una convención informal en una condición verificable.
Las rachas dejaron de ser un pequeño widget
Las rachas empezaron asociadas a retos diarios, pero el producto pedía algo más amplio. La sección evolucionó a una vista de analítica con calendario, tendencias, mapa de actividad, desglose por juego e historial. Después se movió a la navegación principal y se corrigió la semántica para que las partidas normales completadas contaran como actividad.
El detalle competitivo volvió a importar. Una victoria contra CPU cuenta; una derrota o empate no debería inflar una racha de éxito. Sin un resultado común, esta regla habría tenido que implementarse de forma específica dentro de cada motor.
La evolución de rachas es un buen ejemplo de cómo una función aparentemente “de interfaz” termina presionando la arquitectura. El momento en que quieres sumar actividad de decenas de juegos es el momento en que descubres si todos hablan el mismo idioma.
La interfaz compartida también tuvo que crecer
Los nuevos juegos pusieron a prueba decisiones visuales que parecían resueltas. Logic Matrix y Zebra Grid mostraron que los tamaños tipográficos y de tablero no podían quedar escondidos en excepciones locales. Un número dentro de una pista no puede verse a la mitad del tamaño de un icono y seguir siendo una pista útil. Un tablero de candidatos no puede encogerse hasta volverse decorativo sólo para caber junto a una columna de texto.
La respuesta no fue hacer todos los juegos idénticos. Fue reforzar una base común y permitir que cada motor use el espacio según su naturaleza. En escritorio, Zebra Grid puede dedicar una columna a las pistas; Logic Matrix distribuye pistas en dos zonas; Numberlink prioriza un tablero grande. En móvil todos necesitan objetivos táctiles legibles y una jerarquía consistente.
Publicar un juego también significa documentarlo
Esta revisión del Blog ha revelado otra inconsistencia: seis juegos con status: available no tenían su artículo correspondiente. No eran juegos en desarrollo. Eran experiencias jugables —Balance Loop, Battleship, Takuzu, Dots and Boxes, Logic Matrix y Zebra Grid— que el catálogo ya podía ofrecer pero la capa editorial todavía no explicaba.
La corrección no consiste sólo en añadir seis páginas. También conviene convertir la relación en un gate: si un juego pasa a available, debe existir una guía editorial asociada. Los juegos coming-soon quedan fuera. Así el criterio refleja el estado real del producto y evita confundir backlog con contenido público.
Es exactamente el mismo patrón que en generación o resultados: una expectativa útil deja de depender de memoria humana y pasa a ser comprobable.
El runner self-hosted forma parte del producto aunque nadie lo vea
Con más tests, validaciones de generación, E2E y automatizaciones, el runner dejó de ser infraestructura incidental. Los problemas de conectividad nocturna obligaron a diagnosticar la red, endurecer la máquina y añadir herramientas de salud sin convertir cada pequeño cambio en una comprobación permanente innecesaria.
El objetivo no es tener más workflows. Es poder confiar en los que existen. Una PR que espera indefinidamente a un runner no ofrece una garantía de calidad; bloquea el sistema que debería proporcionarla.
La lección encaja con el resto del trabajo: una verificación sólo tiene valor si su propia ejecución es fiable.
Qué ha cambiado realmente
Visto desde fuera, han aparecido juegos, tamaños, rachas y pantallas. Visto desde dentro, el cambio mayor es otro: cada vez hay menos espacio para que un motor sea una isla. Disponibilidad, i18n, onboarding, resultado, persistencia, responsive, dificultad, solución única, Blog y CI forman un conjunto de contratos alrededor del juego.
Eso aumenta el trabajo de publicar una novedad, pero reduce el coste de mantenerla. Cuando un requisito está en un test o en una fuente de verdad, no hace falta recordar manualmente cómo se comportaban treinta motores distintos.
El siguiente problema interesante es simplificar
Este crecimiento también ha acumulado scripts y capas de publicación. El build encadena demasiadas fases heredadas de distintas etapas del proyecto. Ahora que los contratos importantes están más claros, el siguiente trabajo no debería consistir en sumar otra capa cada vez que aparece una excepción, sino en eliminar duplicaciones y dejar una ruta más corta entre fuente, verificación y despliegue.
La paradoja es sana: después de añadir mucha capacidad, toca reducir complejidad accidental. La plataforma puede seguir creciendo si cada juego nuevo aporta principalmente su lógica propia y reutiliza el resto.
Una definición más exigente de “terminado”
Un puzzle terminado ya no es un tablero que se puede abrir y completar una vez. Debe ser jugable en móvil y escritorio, tener controles claros, generar partidas válidas, demostrar unicidad cuando corresponde, diferenciar dificultades, persistir estado, informar un resultado común, integrarse con progreso, estar localizado y tener documentación pública coherente.
No todos los juegos futuros necesitarán exactamente las mismas piezas. Un competitivo no tiene solución única; un puzzle estático puede no generar nada. La clave es que las diferencias sean explícitas y que la plataforma sepa qué contrato aplicar a cada modo.
Ese es el cambio que más me interesa de esta etapa. Blupoli Puzzles está dejando de ser una suma de implementaciones y empieza a comportarse como un sistema. Los juegos siguen siendo el centro, pero cada uno llega acompañado de pruebas, datos y convenciones que permiten que el siguiente no empiece desde cero.
La publicación también empezó a necesitar una definición de estado
Otro efecto de este crecimiento ha sido distinguir mejor entre “existe en el repositorio” y “está publicado”. La carpeta games/ contiene tanto juegos disponibles como otros que siguen en desarrollo. Si una comprobación editorial recorre simplemente todos los game.json, termina exigiendo artículos para prototipos que todavía no deberían presentarse al público.
El criterio útil es status: available. Esa propiedad ya participa en otras verificaciones de plataforma y ahora también puede definir qué juegos necesitan una guía pública. La diferencia parece pequeña, pero evita que el repositorio técnico se convierta accidentalmente en el catálogo editorial.
Esta separación también permite trabajar con más libertad en motores futuros. Podemos añadir manifiestos, pruebas o esqueletos sin que el sistema los trate como lanzamientos. El momento de cambiar a available se convierte en un acto explícito con consecuencias: el juego entra en catálogo, progreso, cobertura de resultados y documentación.
Los seis huecos editoriales mostraron el valor de un gate
La auditoría encontró Balance Loop, Battleship, Takuzu, Dots and Boxes, Logic Matrix y Zebra Grid como juegos disponibles sin artículo dedicado. La reacción inicial podría haber sido simplemente escribir seis páginas y dar por cerrado el problema. Pero esa solución habría dejado intacta la causa: no existía ninguna relación automática entre disponibilidad y cobertura editorial.
El nuevo test recorre los juegos publicados y exige una guía española y otra inglesa para cada uno. Los coming-soon quedan fuera. Es un test pequeño, pero encaja con la filosofía que se ha ido consolidando en todo el proyecto: si una expectativa es importante y verificable, debería vivir cerca del código y no depender de una lista mental.
Además obliga a pensar en la guía como parte de la definición de terminado. Un juego puede funcionar técnicamente y aun así estar mal integrado si nadie puede encontrar una explicación clara de sus reglas, dificultad o particularidades.
El Blog y el Devlog cumplen papeles diferentes
Los seis artículos nuevos pertenecen al Blog porque están pensados para quien quiere entender y jugar esos puzzles. Explican reglas, estrategias, dificultad, relación con otros juegos y decisiones de experiencia que afectan al jugador. No necesitan contar cada iteración interna que llevó al resultado.
Este artículo, en cambio, pertenece al Devlog porque el tema interesante es el proceso: cómo varios cambios independientes acabaron señalando el mismo problema de arquitectura y producto. La distinción evita que el Blog se convierta en un changelog y que el Devlog repita guías de juego.
Separar ambos formatos también mejora el enlazado interno. Una guía puede apuntar a la historia técnica cuando aporta contexto, y el Devlog puede conducir a los juegos concretos sin obligar al lector a atravesar detalles de implementación para aprender a jugar.
El problema de las soluciones superpuestas
La velocidad de desarrollo ha dejado otra señal clara: el build acumula capas de normalización, localización, enriquecimiento y corrección creadas en momentos distintos. Muchas existen por buenas razones históricas, pero juntas hacen que una modificación editorial o de catálogo recorra demasiadas fases antes de convertirse en salida final.
Esto se parece a lo que ocurrió con los motores antes de establecer contratos comunes. Cuando cada problema se resuelve localmente, el sistema crece por acumulación. Después llega un punto en que simplificar produce más valor que añadir una capa nueva.
La limpieza no debería eliminar verificaciones deterministas útiles. Generar rutas, validar sintaxis, comprobar traducciones, demostrar soluciones o construir sitemaps siguen siendo trabajo de software. Lo que sí merece revisión son las secuencias “normalizar → parchear → volver a normalizar” que existen porque varias generaciones de arquitectura editorial conviven al mismo tiempo.
Qué conviene automatizar y qué conviene dejar como juicio editorial
La experiencia de estas semanas también ha aclarado una frontera. La unicidad de un puzzle, la existencia de un artículo, la sintaxis de un fichero o la presencia de traducciones completas son condiciones binarias que una máquina puede comprobar. La calidad de una explicación, el ritmo de un artículo o si una infografía realmente ayuda a entender el tema necesitan juicio editorial.
Intentar automatizar lo segundo como si fuera lo primero produce texto correcto pero mediocre. Dejar lo primero en manos de memoria humana produce regresiones evitables. El sistema funciona mejor cuando cada capa asume el tipo de decisión para el que es buena.
Las skills de Blog y Devlog reflejan esta idea: definen un estándar editorial y un bucle de revisión, mientras los scripts se encargan de metadatos, rutas, localización y gates técnicos. El objetivo no es que una parte sustituya a la otra, sino que se complementen.
Por qué las pruebas de dificultad importan más a medida que crece el catálogo
Con pocos juegos, una etiqueta de dificultad mal calibrada puede detectarse jugando manualmente. Con decenas de motores, tamaños y semillas, esa estrategia no escala. Los tests estructurales de Logic Matrix, Zebra Grid o Numberlink no pretenden sustituir la experiencia humana, pero sirven como barrera contra regresiones obvias.
Si Experta empieza a contener una proporción de pistas directas similar a Fácil, o si una ampliación de tamaños rompe el umbral de calidad de un tablero conocido, una prueba puede avisar antes de publicar. Después sigue siendo necesario jugar y ajustar sensaciones, pero ya no partimos de cero.
La dirección útil es combinar métricas reproducibles con revisión humana. Ni una puntuación de solver es “la dificultad real”, ni una impresión aislada es suficiente para garantizar una progresión estable en cientos de partidas generadas.
La plataforma empieza a tener invariantes propios
Un invariante es algo que debería mantenerse verdadero aunque cambie la implementación. En Blupoli Puzzles empiezan a aparecer varios: todo juego disponible debe poder informar su resultado; todo puzzle generado que lo requiera debe demostrar unicidad; las dificultades deben mantener un orden razonable; las rutas publicadas deben localizarse; los artículos de juegos disponibles deben existir en los idiomas fuente.
Estos invariantes son más importantes que muchos detalles internos porque permiten refactorizar con confianza. Podemos cambiar un algoritmo, un componente visual o una estructura de directorios mientras los contratos sigan pasando.
Cuantos más motores haya, más valor tiene esta capa. El proyecto deja de depender de recordar las peculiaridades históricas de cada juego y pasa a depender de reglas de plataforma que se pueden comprobar.
Un criterio más útil para decidir cuándo parar una iteración
En trabajo asistido por agentes es fácil seguir añadiendo mejoras porque siempre aparece otra posibilidad. Los contratos verificables ayudan a definir un punto de cierre: el juego cumple reglas, generación, dificultad, responsive, resultado, localización, documentación y CI. Después puede seguir mejorando, pero ya no está bloqueado por una carencia fundamental.
Esto no convierte la calidad en una lista mecánica. La revisión visual y la experiencia de juego siguen siendo necesarias. Lo que hace es evitar que “parece terminado” sustituya a comprobaciones concretas.
El mismo enfoque sirve para una PR editorial. El artículo debe existir en ambos idiomas, integrarse en su índice, tener metadatos coherentes y no romper el build. Sólo entonces tiene sentido juzgar si el texto cuenta una historia que merece publicarse.
Lo que esta etapa deja preparado
La consecuencia más importante de todo este trabajo no es una lista de funcionalidades. Es que el siguiente juego puede heredar más cosas de la plataforma: shell, resultados, progreso, rachas, onboarding, localización, patrones responsive y gates. Cuanto mayor sea esa herencia, más tiempo se puede dedicar a lo que realmente distingue al nuevo puzzle.
También deja una lista clara de deuda que merece reducirse: demasiadas fases de build, convenciones editoriales todavía repartidas y algunos sistemas nacidos como parches que ahora deberían consolidarse. Esa limpieza es más fácil precisamente porque los contratos esenciales están empezando a quedar escritos.
La ambición no es que todos los juegos compartan el mismo código. Es que compartan expectativas de calidad y de producto. Un motor puede ser completamente distinto por dentro y seguir encajando en la misma plataforma por fuera.