
Un botón de «Nueva partida» comprime un problema sorprendentemente grande en una interacción de un segundo. La persona espera que aparezca un reto nuevo, válido, razonablemente distinto del anterior y adecuado a la dificultad elegida. Si el puzzle necesita solución única, también espera que no exista otra respuesta igual de legítima. Y espera todo eso sin tener que contemplar cómo el sistema prueba cientos de alternativas antes de decidir cuál merece mostrarse.
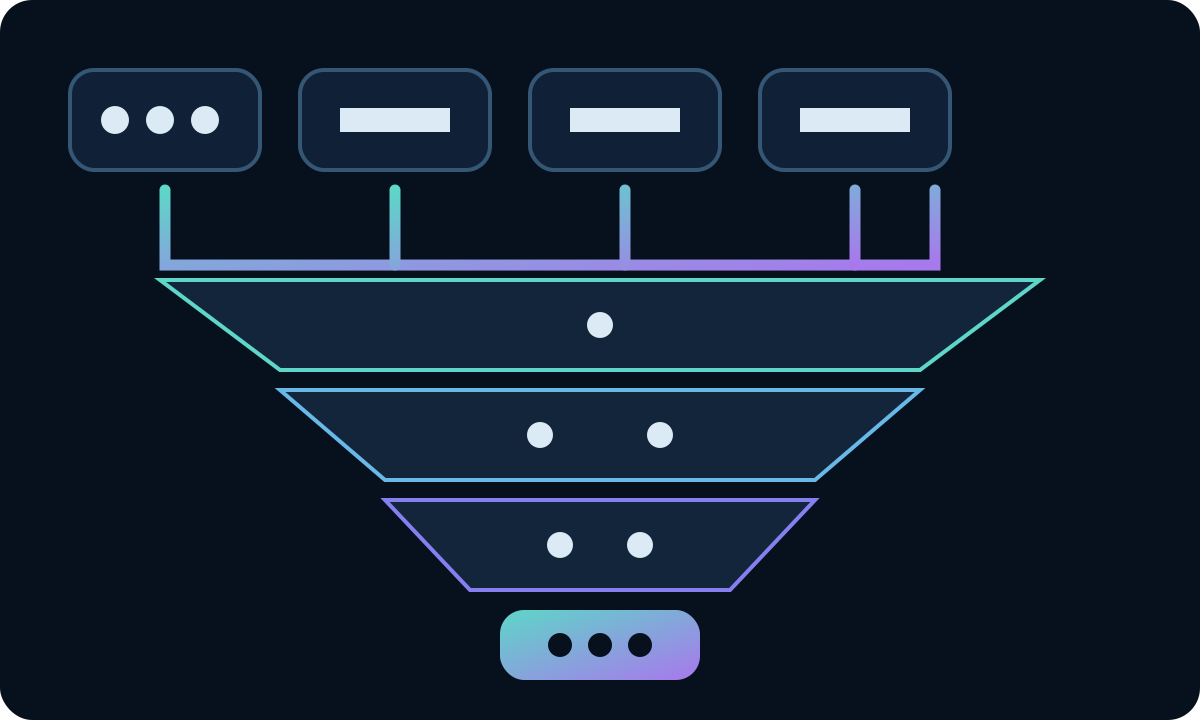
Durante el crecimiento de Blupoli Puzzles, esta parte se convirtió en una de las lecciones técnicas más importantes. Al principio es fácil pensar que generar consiste en producir cualquier estado inicial que respete las reglas. La realidad es más exigente: validez es el suelo, no el techo. Un generador útil se parece menos a una fábrica indiscriminada y más a un editor. Propone, comprueba, compara y rechaza. Solo una fracción de lo que puede crear debería llegar al jugador.
Resolver responde una pregunta distinta de generar
Un solver recibe un puzzle y busca una solución. Un generador parte del problema opuesto: necesita construir una instancia que tenga determinadas propiedades. Ambos pueden compartir conocimiento sobre las reglas, pero su objetivo no es el mismo. Encontrar una solución para un tablero demuestra que el tablero es resoluble; no demuestra que sea único, interesante, apropiado para una dificultad o eficiente de producir de nuevo.
Esta separación parece académica hasta que un generador empieza a depender demasiado de la lógica del solver. Puede caer en el patrón de «creo algo, compruebo que tenga solución y lo publico». Esa cadena valida muy poco. Un producto de puzzles necesita una tercera función: evaluar. La evaluación observa propiedades que van más allá de la mera existencia de una solución. Crear, resolver y evaluar forman un sistema; confundirlos hace más difícil razonar sobre cada responsabilidad.
La trampa del tablero visualmente plausible
Muchos errores de generación son peligrosos precisamente porque no se ven a primera vista. Un Nonogram puede presentar pistas con aspecto razonable y admitir más de una imagen. Un juego de caminos puede mostrar parejas bien distribuidas y tener una solución casi forzada desde el primer movimiento. Un Kakuro puede respetar sumas y ofrecer combinaciones demasiado obvias. La interfaz no distingue por sí sola un buen candidato de uno mediocre.
Esto crea una analogía útil con el desarrollo asistido por IA: producir una salida convincente es más fácil que demostrar sus propiedades. Por eso nuestro flujo con agentes insiste tanto en evidencia independiente. En generación procedural ocurre lo mismo. El generador no debería ser el único juez de su trabajo. Necesita herramientas capaces de contradecirlo.
Un solver puede actuar como inspector de la fábrica
Una de las formas más útiles de emplear un solver es fuera de la experiencia del jugador. El generador propone un candidato y el solver lo inspecciona. Puede comprobar que existe al menos una solución, buscar más de una, medir cuántas decisiones aparecen o registrar qué técnicas fueron necesarias para avanzar. La misma lógica que resuelve se convierte en instrumento de fabricación.
Eso no significa que el solver defina por completo la calidad. Hay propiedades de experiencia que no aparecen directamente en su traza. Pero ofrece señales reproducibles y mucho más fiables que una intuición codificada como «si el tablero es grande, será difícil». El solver transforma parte de la dificultad y la unicidad en algo que podemos observar, comparar y convertir en regresiones cuando encontramos un caso problemático.
Encontrar una solución no demuestra unicidad
Este es uno de los errores conceptuales más sencillos y más importantes. Si un algoritmo encuentra una solución, solo ha demostrado que existe al menos una. En familias donde el diseño exige una respuesta única, la búsqueda debe continuar o utilizar restricciones capaces de demostrar que cualquier alternativa conduce a contradicción. Detenerse en el primer éxito puede publicar una pregunta ambigua.
Para el jugador, la ambigüedad es especialmente injusta. Puede razonar correctamente, llegar a una configuración válida y encontrarse con que la aplicación esperaba otra. En ese escenario el fallo no pertenece a quien juega; pertenece al generador, que no demostró suficientemente la pregunta que estaba formulando. La unicidad no es una mejora opcional cuando forma parte del contrato del puzzle. Es una propiedad que debemos poder justificar.
Rechazar es parte central del algoritmo
Un generador ingenuo se mide por cuántos candidatos produce. Uno maduro se mide también por qué sabe descartar. Un tablero puede ser resoluble y tener la dificultad equivocada. Puede ser único y repetir demasiado un patrón reciente. Puede ser interesante pero demasiado caro de validar dentro del presupuesto de tiempo. Puede cumplir todas las reglas y contener una estructura degenerada que hace la partida poco satisfactoria.
La capacidad de decir «no» cambia la arquitectura. Ya no basta con una función que devuelve un tablero. Necesitamos un proceso que pueda fallar de manera normal, registrar por qué un candidato fue rechazado, intentar de nuevo y disponer de estrategias de fallback. El rechazo deja de ser una excepción y se convierte en el mecanismo mediante el cual la calidad entra en la generación.
Norinori nos enseñó a preferir menos variedad a variedad falsa
En la etapa inicial del catálogo aparecieron casos donde una estrategia de generación producía instancias ambiguas o poco fiables. Norinori fue uno de los ejemplos que reforzó una idea importante: preferimos eliminar una estrategia que no podemos validar bien antes que conservarla solo para que el juego parezca más variado. Una fuente de diversidad que rompe el contrato no es diversidad útil.
Esta decisión resulta incómoda porque reduce opciones visibles a corto plazo. Sin embargo, protege algo más valioso: la confianza en que una partida publicada merece ser tratada como un problema bien definido. En un catálogo amplio, esa confianza necesita ser transversal. Si algunos juegos aceptan ambigüedad accidental y otros no, el jugador no sabe qué reglas implícitas puede asumir. La consistencia de calidad también forma parte de la identidad de plataforma.
La dificultad necesita una teoría, aunque sea imperfecta
Etiquetar un puzzle como Fácil, Normal, Difícil o Experto exige algún modelo de por qué esas categorías son distintas. El modelo puede evolucionar y no tiene por qué capturar perfectamente la experiencia humana, pero debe ser mejor que cambiar arbitrariamente el tamaño. Un tablero enorme con decisiones obvias puede resultar más fácil que uno pequeño con una deducción profunda.
Las señales dependen de cada familia: número de pasos forzados, branching, técnicas lógicas, combinaciones candidatas, densidad de pistas, longitud de caminos, simetría o estructura de regiones. Un buen sistema de dificultad no pretende reducir todos los puzzles a una métrica idéntica. Pretende que dentro de cada juego exista una relación reproducible entre la etiqueta y el razonamiento que la partida solicita.
Numberlink mostró cómo una dificultad puede ser falsa
Numberlink puso este problema en una forma muy clara. Podíamos generar tableros válidos y, aun así, observar que incluso niveles teóricamente altos contenían caminos demasiado evidentes. La aplicación podía comenzar, aceptar movimientos y terminar correctamente. El fallo estaba en otro lugar: casi no había decisiones interesantes.
Eso obligó a cambiar la pregunta de ingeniería. En vez de «¿cómo generamos un Numberlink?», tuvimos que preguntar «¿qué propiedades hacen interesante un Numberlink?». La diferencia es enorme. La primera pregunta se satisface con corrección estructural. La segunda exige estudiar el espacio de decisiones, los cuellos de botella y el modo en que las pistas restringen progresivamente el tablero. Un generador necesita una teoría mínima de la experiencia que pretende producir.
Medir dificultad con el solver tiene límites
Un solver puede ofrecer datos excelentes, pero hay que interpretar qué representan. Un algoritmo de búsqueda puede explorar ramas que una persona nunca consideraría. Una heurística diseñada para resolver rápido puede ocultar las técnicas humanas que hacen memorable un puzzle. Dos instancias con coste computacional parecido pueden sentirse muy distintas si una depende de una deducción elegante y otra de repetir pasos rutinarios.
Por eso las métricas automáticas son señales, no oráculos. Podemos combinar varias: número de decisiones, profundidad, técnicas, alternativas descartadas, distribución espacial o progreso por fases. Después necesitamos contrastarlas con la experiencia. La ventaja de instrumentar el solver no es obtener una verdad absoluta; es pasar de etiquetas arbitrarias a hipótesis que podemos medir, comparar y corregir.
El tiempo de generación también es una restricción de producto
Buscar el puzzle perfecto de manera indefinida no sirve si la persona está esperando delante de la pantalla. La generación tiene un presupuesto. Necesita límites de intentos, tiempos máximos y estrategias para responder cuando los filtros de calidad rechazan demasiados candidatos. Una solución algorítmicamente elegante puede ser una mala decisión de producto si bloquea la interacción.
Este límite crea una tensión interesante. Cuanto más exigente es la política de calidad, más candidatos pueden fallar. La salida no debería ser simplemente aumentar el tiempo disponible. El trabajo de optimización consiste en mejorar la distribución de candidatos: producir desde el principio estructuras con mayor probabilidad de superar los filtros. Un buen generador no es el que busca durante más tiempo; es el que desperdicia menos intentos.
Los fallbacks deben estar diseñados, no improvisados
Si un generador llega a su presupuesto sin encontrar una instancia aceptable, necesita saber qué hacer. Puede reducir una restricción no esencial, cambiar de estrategia, utilizar una instancia prevalidada o solicitar otro intento con parámetros ajustados. Lo que no debería ocurrir es publicar el último candidato solo porque se agotó el tiempo. El fallback no puede anular justamente los criterios que protegen la experiencia.
Diseñar estas rutas obliga a ordenar prioridades. Algunas condiciones son innegociables, como la validez o la unicidad cuando el juego la exige. Otras pueden admitir gradación, como una puntuación de variedad. Expresar esa jerarquía en el código hace que los fallos sean más previsibles y que un límite de rendimiento no se convierta en una puerta trasera hacia partidas defectuosas.
Las semillas convierten fallos aleatorios en casos reproducibles
La aleatoriedad es útil para ofrecer variedad, pero complica la depuración. Un usuario puede encontrar una partida mala que nunca vuelve a aparecer durante una prueba manual. Introducir semillas controladas permite conservar el candidato exacto, reproducirlo y utilizarlo para evaluar cambios posteriores. La aleatoriedad puede seguir existiendo hacia fuera mientras la ingeniería obtiene determinismo cuando lo necesita.
Esta capacidad es especialmente valiosa para crear regresiones. Si una semilla produjo una solución múltiple o una dificultad absurda, podemos guardarla y exigir que futuras versiones no repitan el problema. El bug deja de ser «a veces pasa» y se convierte en una prueba concreta. Con suficientes casos, el historial de semillas problemáticas funciona como una memoria del generador y protege contra recaídas.
La variedad también necesita memoria
Un generador puede producir individualmente buenas partidas y resultar repetitivo en conjunto. Si todas comparten el mismo patrón estructural, el jugador detecta pronto la receta. La calidad de una sesión no depende solo de cada instancia aislada; depende también de la distancia respecto a lo que acaba de ocurrir.
Esto sugiere otro tipo de evaluación: comparar candidatos con un historial reciente o con distribuciones esperadas. Podemos observar posiciones, formas, densidades, tipos de técnica o cualquier rasgo relevante para la familia. No es necesario perseguir aleatoriedad máxima. De hecho, demasiada aleatoriedad puede generar ruido. Buscamos diversidad significativa: partidas que exploran distintas zonas del espacio de diseño sin abandonar los estándares de calidad.
Generar bien exige entender la familia, no solo el formato
No existe una métrica universal de «buen puzzle». En Nonogram la calidad puede depender de cómo las pistas permiten deducciones progresivas. En Kakuro importan combinaciones y cruces. En Slitherlink aparecen restricciones locales que deben construir un único ciclo. En un juego de sombreado intervienen conectividad, regiones y patrones prohibidos. La plataforma puede compartir infraestructura, pero la evaluación necesita conocimiento específico.
Esta es una extensión natural de la arquitectura de motores. Compartimos el proceso —proponer, validar, medir, seleccionar— y dejamos que cada familia defina las señales que importan. Intentar forzar un único evaluador para todos produciría métricas superficiales. La reutilización útil está en el marco, no en fingir que todos los puzzles son el mismo problema.
Un solver tampoco sirve igual para todos los puzzles
A medida que el catálogo creció, se volvió evidente que «tener un solver» no es una casilla homogénea. Algunas familias se prestan a propagación de restricciones, otras a backtracking, otras a grafos o algoritmos específicos. Incluso cuando dos problemas pueden resolverse con una búsqueda genérica, la información que necesitamos para evaluar dificultad puede requerir instrumentación distinta.
Por eso evitamos convertir el solver en una megaabstracción. El contrato compartido puede expresar preguntas comunes —resoluble, número de soluciones, señales de coste— mientras la implementación conserva libertad. Esta idea se desarrolla también en «Un solver no sirve para todos». La infraestructura debe hacer comparables los resultados sin borrar la naturaleza del problema.
La generación forma parte del diseño del juego
Es tentador pensar que las reglas constituyen «el juego» y que el generador es una utilidad técnica que simplemente suministra contenido. En una experiencia procedural, ocurre algo más profundo. Las reglas definen todo el espacio de partidas posibles; el generador decide qué fracción de ese espacio verá realmente el jugador. Dos generadores bajo las mismas reglas pueden producir productos radicalmente distintos.
Eso convierte decisiones algorítmicas en decisiones de diseño. La distribución de pistas, la frecuencia de ciertas técnicas, la probabilidad de una estructura rara o el modo en que escala la dificultad determinan la personalidad de la experiencia. Revisar un generador no es optimizar una función interna sin consecuencias visibles. Es editar el material con el que el jugador tendrá que pensar.
Los filtros pueden convertirse en especificación ejecutable
Una ventaja de formalizar la generación es que muchas expectativas dejan de vivir solo en documentos. Si exigimos unicidad, el sistema puede comprobarla. Si una banda de dificultad necesita determinadas señales, podemos definir umbrales y registrar resultados. Si ciertos patrones están prohibidos, pueden convertirse en validadores. La especificación gana una parte ejecutable.
Esto encaja especialmente bien con el uso de agentes de IA. Una herramienta puede modificar un generador con rapidez, pero los filtros existentes establecen condiciones que no puede ignorar sin hacer fallar el build o la prueba. El conocimiento del producto queda parcialmente protegido por código independiente de quien realiza el cambio. Cuanto más repetible sea la verificación, menos dependemos de recordar manualmente todos los detalles durante cada revisión.
La telemetría de desarrollo importa incluso sin medir usuarios
No necesitamos observar el comportamiento personal de jugadores para instrumentar un generador durante el desarrollo. Podemos registrar cuántos candidatos se intentan, por qué se rechazan, cuánto cuesta resolverlos, qué puntuaciones reciben o qué semilla produjo un caso extremo. Estos datos permiten comparar versiones del algoritmo sobre el mismo conjunto de condiciones.
La clave es separar métricas de ingeniería de conclusiones sobre experiencia. Que una versión reduzca a la mitad los intentos no significa que sus puzzles sean mejores; significa que es más eficiente bajo los filtros actuales. Si además mantiene o mejora las señales de calidad, entonces tenemos una evidencia más completa. La instrumentación sirve para hacer preguntas más precisas, no para sustituir la evaluación del producto.
El mejor generador aprende a fallar de forma comprensible
La generación procedural siempre puede encontrar casos límite. Un conjunto de parámetros puede ser demasiado restrictivo, un tamaño puede disparar el coste o una combinación rara puede agotar intentos. El sistema maduro no es el que promete que nunca fallará. Es el que falla de forma acotada, registra la causa y utiliza una estrategia conocida para recuperarse sin publicar basura.
Esto mejora también la depuración. «No se pudo generar porque 200 candidatos fallaron unicidad» ofrece una dirección. «No funciona» no. Diseñar errores y contadores alrededor del generador convierte una caja negra en un proceso observable. Y la observabilidad hace posible optimizar con intención en vez de cambiar heurísticas a ciegas.
Pulsar «Nueva partida» es confiar en una cadena de decisiones
La experiencia final sigue siendo simple: el usuario pulsa un botón y aparece un puzzle. Todo el sistema de solvers, métricas, semillas, filtros y presupuestos debería quedar invisible. Esa invisibilidad es el objetivo, no una señal de que la complejidad no exista. Cuanto mejor funciona la infraestructura, menos necesita pensar la persona en ella.
Por eso generar y resolver son disciplinas relacionadas pero distintas. Resolver ayuda a demostrar. Generar propone. Evaluar decide si lo propuesto alcanza el estándar. Y el producto añade restricciones de tiempo, variedad y experiencia que ninguna de esas funciones puede ignorar. Cuando tratamos cada responsabilidad con claridad, «Nueva partida» deja de ser una lotería y se convierte en una promesa razonable de que el siguiente reto también merece la pena.
La calidad de un generador se mide por sus rechazos
Al final, la idea más importante es casi contraintuitiva. Un generador no es mejor porque consiga publicar todo lo que crea. Es mejor cuando sabe distinguir entre lo posible y lo deseable. La lista de candidatos descartados no representa trabajo perdido; representa el filtro que separa el espacio matemático del espacio de experiencias que queremos ofrecer.
Blupoli Puzzles seguirá refinando esas fronteras juego a juego. No existe una fórmula única y no todas las familias necesitan las mismas garantías. Pero el principio común está claro: antes de mostrar un puzzle debemos poder explicar, al menos en términos técnicos, por qué lo consideramos válido, qué sabemos sobre su solución y qué señales justifican su dificultad o calidad. Generar no es resolver. Y resolver, por sí solo, tampoco basta para editar una buena partida.